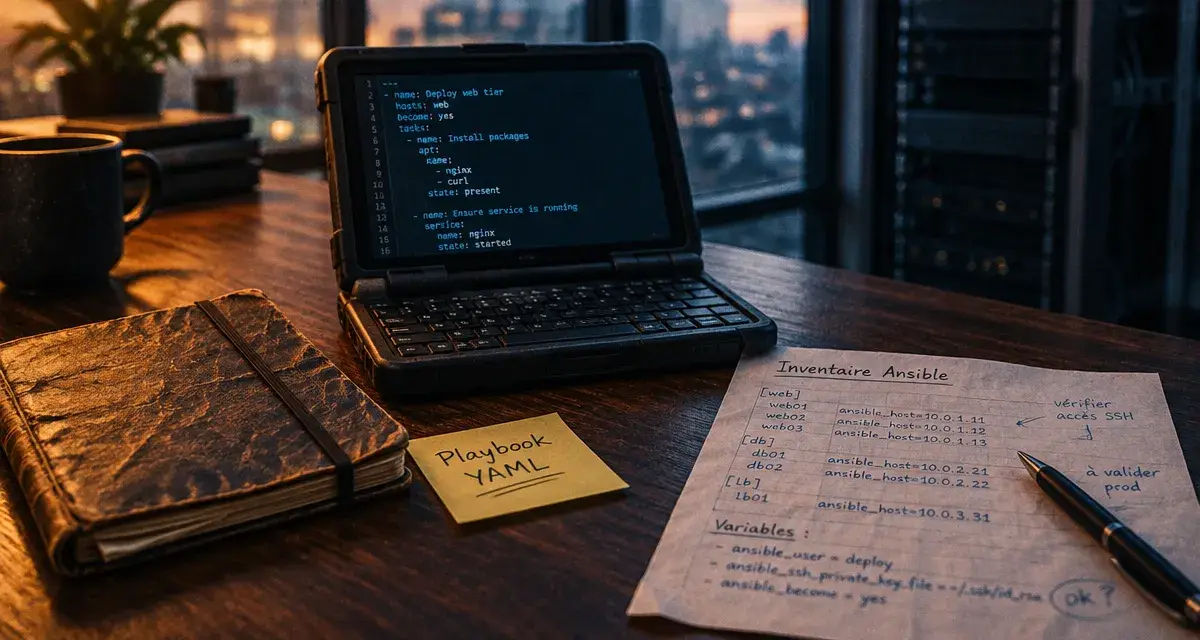
Apprendre Ansible ne consiste pas à mémoriser une longue liste de commandes. Il faut surtout décrire l’état attendu de vos machines, puis laisser l’outil appliquer les changements nécessaires. Ce tutoriel Ansible vous guide du poste de contrôle à votre premier playbook exploitable, avec les repères nécessaires pour automatiser votre infrastructure sans perdre la maîtrise des opérations.
Comprendre ce qu’Ansible automatise réellement
Ansible est un outil d’automatisation destiné notamment à l’administration système, au déploiement applicatif, au provisioning et à la gestion de configuration. Créé en 2012, il s’est imposé dans les pratiques DevOps grâce à des fichiers YAML relativement lisibles, qui décrivent les actions attendues. Une même définition peut installer un paquet, créer un utilisateur, modifier une configuration ou déployer une application sur plusieurs serveurs.
Une architecture sans agent sur les machines gérées
Le control node est la machine depuis laquelle vous lancez Ansible. Les serveurs ciblés sont les managed nodes. Dans de nombreux environnements Linux, Ansible communique avec eux par SSH. Il n’est donc pas nécessaire d’installer un agent Ansible permanent sur chaque cible. Vous devez toutefois prévoir un accès réseau, une authentification SSH fonctionnelle et les privilèges adaptés aux tâches à exécuter.
Cette architecture limite le nombre de composants à maintenir, mais elle exige une préparation rigoureuse. Le compte utilisé doit disposer des droits nécessaires, sans davantage. Une clé SSH dédiée, une gestion séparée des secrets et des comptes individuels sont généralement préférables à une connexion administrateur partagée entre plusieurs usages.
Les quatre briques à retenir avant de commencer
| Élément | Rôle | À retenir |
|---|---|---|
| Inventory | Liste et organise les hôtes ciblés | Il associe des groupes à des adresses IP ou à des noms DNS. |
| Module | Réalise une action précise | Il peut gérer un paquet, un fichier, un utilisateur ou un service. |
| Playbook | Enchaîne des tâches déclaratives | Il décrit l’état souhaité dans un fichier YAML. |
| Role | Structure un ensemble réutilisable | Il devient utile lorsque les playbooks prennent de l’ampleur. |
Préparer un environnement de test propre et contrôlable
Commencez avec une machine de contrôle Linux, macOS ou un environnement compatible, puis avec un ou deux serveurs de test. Sous Windows, Ansible est habituellement administré depuis un environnement Linux plutôt que directement depuis le système hôte. Installez Ansible avec le gestionnaire de paquets ou le mécanisme recommandé par votre distribution, puis vérifiez que la commande ansible est disponible dans le terminal.
Écrire un inventaire minimal
Créez un fichier d’inventaire avec un groupe, par exemple web, puis ajoutez les hôtes à administrer. Chaque ligne peut contenir une adresse DNS ou IP ainsi que les variables de connexion utiles. Gardez ce premier inventaire simple. Votre priorité est de valider la connectivité, pas de reproduire toute l’organisation de votre infrastructure.
Avant d’écrire un playbook, lancez le module de test ping sur le groupe concerné. Si la réponse échoue, traitez le problème à ce stade : nom d’hôte, pare-feu, clé SSH, utilisateur distant ou élévation de privilèges. Un playbook ne corrige pas une connexion défaillante. Il risque plutôt de rendre le diagnostic plus difficile.
Structurer l’inventaire selon les fonctions
Un inventaire ne sert pas uniquement à stocker des adresses. Il relie votre intention d’automatisation aux machines réelles. Si les groupes reflètent les fonctions, comme web, base de données, préproduction ou production, vous pouvez appliquer des règles cohérentes sans mélanger les périmètres. Ce découpage facilite aussi les déploiements progressifs : appliquez d’abord un changement à un groupe pilote, observez le résultat, puis étendez-le. Une organisation claire réduit les risques lorsque les tâches deviennent plus nombreuses.
Créer un premier playbook utile avec Nginx
Un playbook est un fichier YAML composé de « plays ». Chaque play cible des hôtes et regroupe des tâches. L’indentation est significative : utilisez des espaces de façon constante et évitez les tabulations. Pour ce premier exercice, l’objectif est précis : installer Nginx sur le groupe web, puis vérifier que son service est démarré.
Décrire l’état attendu plutôt qu’une suite de gestes manuels
Le playbook doit cibler le groupe web et activer l’élévation de privilèges si l’installation l’exige. Il contient ensuite deux tâches. La première utilise le module de gestion des paquets adapté au système pour demander la présence de Nginx. La seconde utilise le module de service pour demander que Nginx soit démarré et activé au démarrage. Donnez un nom explicite à chaque tâche : pendant l’exécution, ces libellés rendent le résultat immédiatement compréhensible.
Lancez ensuite le playbook avec la commande ansible-playbook, en indiquant l’inventaire et le fichier YAML. La première exécution peut signaler des changements. Si vous relancez le même playbook sans modifier les serveurs, le résultat attendu est l’absence de changement : Nginx est déjà installé et son service respecte déjà l’état demandé.
L’idempotence, le réflexe qui rend l’automatisation fiable
Cette propriété s’appelle l’idempotence. Elle distingue une automatisation déclarative d’un script qui répète les mêmes commandes sans vérifier le résultat. Privilégiez donc les modules qui expriment un état, comme présent, absent, démarré ou arrêté, plutôt que des commandes shell non contrôlées. Les commandes ponctuelles restent utiles pour diagnostiquer un problème ou gérer une exception, mais elles demandent davantage de précautions pour être relancées sans effet indésirable.
Passer d’un essai isolé à des playbooks maintenables
Après un premier succès, vous pouvez être tenté d’ajouter toutes les tâches dans un seul fichier. Résistez à cette approche lorsque le périmètre grandit. Un playbook court est adapté à l’apprentissage, mais une infrastructure durable a besoin de conventions. Séparez les variables selon les environnements, choisissez des noms de tâches orientés vers le résultat et conservez les fichiers dans un dépôt versionné.
- Variables : évitez de répéter un port, un nom de paquet ou un chemin dans plusieurs tâches.
- Handlers : redémarrez un service uniquement lorsqu’un fichier de configuration a effectivement changé.
- Roles : regroupez les tâches, variables, modèles et handlers par fonction, par exemple dans un rôle Nginx.
- Vérification : testez d’abord sur un hôte pilote et utilisez le mode de contrôle avant les changements sensibles.
- Secrets : ne placez pas de mots de passe ni de clés en clair dans l’inventaire ou les playbooks.
Modules, rôles et choix d’outils
Les modules forment la boîte à outils d’Ansible. Ils couvrent les paquets, les utilisateurs, les fichiers, les services, le cloud et les équipements réseau. Les rôles donnent une organisation réutilisable à ces actions. Par rapport à Puppet ou Chef, Ansible attire souvent par son exécution sans agent et ses playbooks YAML. Puppet et Chef peuvent toutefois mieux convenir à des organisations qui ont déjà construit leurs standards autour de ces écosystèmes. Le choix dépend de vos systèmes, de vos compétences et de votre mode d’exploitation, pas d’une solution universelle.
Progresser avec une méthode qui limite les erreurs
Pour consolider vos acquis, automatisez une tâche que vous réalisez régulièrement : créer un compte technique, déployer une clé publique, appliquer des mises à jour contrôlées ou déposer un fichier de configuration. Travaillez sur un environnement jetable ou non critique, puis examinez attentivement les sorties d’exécution. Les erreurs sont plus faciles à comprendre lorsque le périmètre reste limité.
- Validez la connexion avec l’inventaire et le module ping.
- Écrivez une seule tâche, puis exécutez-la sur un hôte de test.
- Relancez le playbook pour vérifier son idempotence.
- Ajoutez une vérification concrète : service actif, fichier présent ou port accessible.
- Transformez l’exercice en rôle dès que plusieurs fichiers ou environnements sont concernés.
La documentation officielle, les exemples de playbooks et les laboratoires pratiques complètent ce parcours. Une formation structurée peut aussi accélérer la progression si vous devez aborder l’orchestration, la conformité, le cloud ou l’intégration CI/CD. Gardez un principe simple : un changement limité, vérifié et rejouable vaut mieux qu’une automatisation ambitieuse, difficile à expliquer ou à reprendre.