Un LLM local est un modèle de langage exécuté sur votre ordinateur ou votre propre serveur, plutôt que sur l’infrastructure d’un fournisseur cloud. Vous pouvez dialoguer avec une IA, générer du texte, obtenir de l’aide au code ou analyser des documents sans envoyer automatiquement vos requêtes à un service tiers. En contrepartie, la qualité des réponses et la vitesse dépendent directement de votre matériel et du modèle choisi.
Ce qu’un LLM local change par rapport à une IA dans le cloud
Un modèle de langage de grande taille, ou LLM, prédit et produit du texte à partir d’une instruction appelée prompt. En local, la phase d’inférence se déroule sur votre PC, votre Mac, une machine Linux ou un serveur auto-hébergé. Le fichier du modèle est téléchargé, stocké et exécuté chez vous.
À l’inverse, une IA cloud traite généralement la demande sur des serveurs distants. Elle est souvent plus simple à utiliser immédiatement et peut donner accès à de très grands modèles, mais elle suppose une connexion, un compte et l’acceptation des règles du service. Le LLM local privilégie le contrôle de l’environnement : vous choisissez le modèle, l’interface, le rythme des mises à jour et les données auxquelles l’assistant peut accéder.
Confidentialité, disponibilité et souveraineté
Le principal intérêt concerne les données sensibles : notes de réunion, code propriétaire, contrats, dossiers clients, documentation interne ou brouillons. Avec une installation correctement configurée, ces contenus restent sur votre machine. Le fonctionnement hors connexion est également utile en déplacement, dans un environnement isolé ou lorsque l’accès réseau est instable.
Cette autonomie ne garantit toutefois pas la sécurité. Un ordinateur infecté, un serveur exposé sur Internet ou une interface sans contrôle d’accès restent des risques. Le local réduit la circulation des données vers le cloud, mais impose de protéger les comptes, les sauvegardes et les accès à la machine.
Choisir l’outil selon votre besoin, pas selon sa popularité
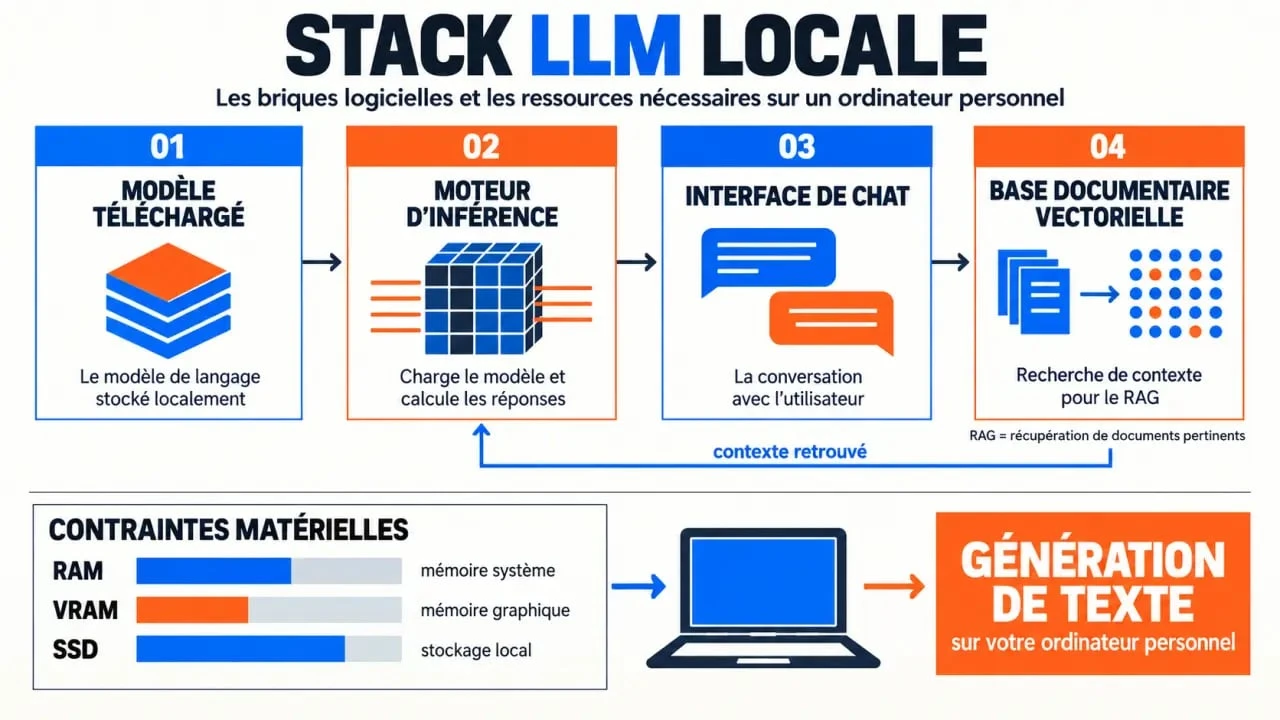
Un LLM local repose souvent sur plusieurs briques : un moteur d’inférence qui charge le modèle, une interface de chat pour converser et, selon le projet, un système de recherche documentaire. Commencer avec une seule brique évite de transformer un premier essai en chantier technique.
| Solution | Pour quel profil ? | Rôle principal | Niveau de prise en main |
|---|---|---|---|
| Ollama | Débutant curieux, développeur | Télécharger et exécuter des modèles avec une approche simple | Accessible |
| LM Studio | Utilisateur de bureau | Tester des modèles avec une interface graphique | Accessible |
| Open WebUI | Équipe ou particulier souhaitant une interface web | Fournir un chat auto-hébergé au-dessus d’un moteur local | Intermédiaire |
| AnythingLLM | Usage documentaire | Organiser des espaces de travail et interroger des fichiers | Intermédiaire |
| vLLM | Équipe technique, serveur dédié | Servir des modèles avec davantage de contrôle et de performance | Avancé |
Une première installation sans se compliquer la vie
Pour un premier essai, Ollama ou LM Studio sont des choix cohérents. Ollama convient si vous acceptez une utilisation orientée commande ou si vous souhaitez ensuite relier le modèle à d’autres applications. LM Studio facilite l’exploration visuelle d’un catalogue de modèles, le réglage de quelques paramètres et le lancement d’une conversation sans coder.
Open WebUI n’est pas un modèle : c’est une interface de chat qui rend un moteur local plus agréable à utiliser, notamment depuis un navigateur. Cette distinction aide à diagnostiquer les problèmes. Si le modèle ne répond pas, la cause peut venir du moteur d’inférence, de la mémoire disponible ou de l’interface, et non du chat lui-même.
Dimensionner votre machine avant de télécharger un modèle
La taille d’un modèle et sa quantification déterminent une grande partie de l’expérience. La quantification réduit la précision numérique utilisée pour stocker le modèle et diminue ainsi son empreinte mémoire. Un modèle quantifié peut devenir utilisable sur une machine plus modeste, avec un compromis possible sur la qualité ou la rapidité.
Installer Ollama et exécuter une IA locale sous Linux — Suivez un guide pratique pour installer Ollama, vérifier votre matériel et lancer des modèles d’intelligence artificielle en local.
- Pour explorer : privilégiez un petit modèle quantifié et conservez plusieurs dizaines de Go libres sur un SSD.
- Pour un usage confortable : 16 à 32 Go de mémoire vive sont recommandés pour des modèles de 7 à 13 milliards de paramètres.
- Pour accélérer : un GPU compatible peut rendre la génération nettement plus fluide en utilisant sa VRAM.
- Pour les grands modèles : les exigences changent d’échelle. Llama 3 70B en Q4 nécessite 40 Go de mémoire. Une RTX 4090 dispose de 24 Go de VRAM, tandis qu’un serveur AMD Ryzen AI Max+ 395 peut proposer 128 Go de mémoire unifiée.
Un modèle plus grand n’est pas forcément plus utile. Pour reformuler des textes, résumer des notes, générer des idées ou produire de petits scripts, un modèle plus compact et réactif offre souvent une meilleure expérience quotidienne. Testez d’abord vos tâches réelles avant d’investir dans une carte graphique ou un serveur.
RAM, VRAM et stockage : trois contraintes différentes
La RAM accueille notamment les données nécessaires à l’exécution lorsque le modèle tourne sur le processeur. La VRAM est la mémoire dédiée du GPU. Elle permet d’y placer une partie ou la totalité du modèle et d’accélérer l’inférence. Le SSD héberge les fichiers parfois volumineux des modèles et améliore les temps de chargement. Une machine avec beaucoup de stockage, mais peu de mémoire, ne résoudra pas le problème d’un modèle trop ambitieux.
Passer de zéro à une première conversation utile
- Choisissez un outil adapté à votre système, parmi Windows 10/11, macOS et Linux. Ollama et LM Studio sont des points de départ courants. Ollama prend aussi en charge l’accélération GPU sous Windows.
- Installez l’outil depuis son site officiel et vérifiez l’espace disponible sur le SSD avant le téléchargement.
- Commencez avec un modèle ouvert de taille raisonnable, par exemple dans les familles Llama, Mistral ou Qwen, en version quantifiée si votre machine est limitée.
- Lancez une invite courte et vérifiable : demandez une reformulation, un plan ou l’explication d’un extrait de code que vous comprenez déjà.
- Observez la vitesse, l’usage mémoire et la cohérence des réponses. Ajustez ensuite la taille du modèle au lieu de multiplier les réglages dès le départ.
Considérez votre installation comme un ensemble de composants. Le modèle apporte les capacités linguistiques, le moteur le fait tourner, l’interface organise la conversation et vos documents fournissent le contexte métier. Identifier la pièce manquante est plus efficace que de changer tout le système. Si les réponses sont vagues, améliorez d’abord le prompt ou les documents fournis. Si elles sont lentes, vérifiez la mémoire, la quantification et le GPU. Si les fichiers sont mal exploités, examinez l’indexation documentaire.
Les usages où l’IA locale apporte une vraie valeur
Un LLM local est particulièrement pertinent lorsque le contenu ne doit pas quitter votre environnement. Il peut servir d’assistant de rédaction privé, d’outil de brainstorming, d’aide au développement ou d’interface de questions-réponses sur une base documentaire interne. Dans ce dernier cas, on parle souvent de RAG : les documents sont découpés et indexés dans une base vectorielle telle que Qdrant ou pgvector, puis les passages pertinents sont transmis au modèle avec la question.
Ne pas lui demander ce qu’il ne peut pas garantir
Un modèle local n’est pas automatiquement connecté à l’actualité, ne vérifie pas spontanément ses affirmations et peut produire des informations plausibles mais fausses. Pour une décision juridique, médicale, financière ou opérationnelle, sa réponse doit rester un brouillon à contrôler. L’absence de cloud ne remplace ni la validation humaine ni une politique de gestion des données.
Si votre priorité est l’accès immédiat aux modèles les plus puissants ou à des fonctions web intégrées, le cloud conserve des avantages. Si vous privilégiez la confidentialité, l’usage hors ligne, la maîtrise de l’environnement et des coûts récurrents, un LLM local bien dimensionné est une solution durable. Commencez avec un cas concret, mesurez l’utilité, puis faites évoluer votre stack vers Open WebUI, AnythingLLM, une base vectorielle ou vLLM lorsque le besoin le justifie.